DatasetsEtruscan: the readable language that cannot be fully translatedOpenEtruscan Etruscan Machine Learning Corpus v1.1.0 (Zenodo)
OpenEtruscan Etruscan Machine Learning Corpus v1.1.0 (Zenodo)
A cleaned and deduplicated merge of the Larth dataset (about 71 per cent of rows) and CIE volume I (about 29 per cent): 6,567 inscription rows with transliteration, translation where available, find-site, date range and links to Trismegistos, EAGLE and Pleiades identifiers. Deposited on Zenodo in 2026 under CC BY 4.0 by Edoardo Panichi; the live site serves 5,932 texts after further deduplication.
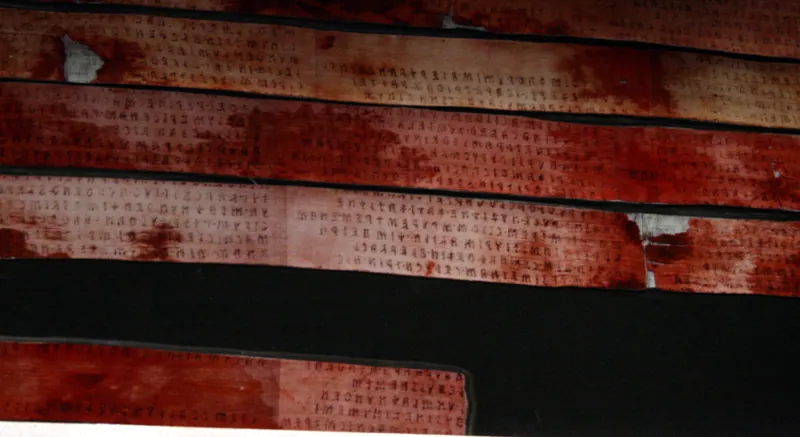 Etruscan: the readable language that cannot be fully translatedVersion 1.0Licence CC BY 4.0Updated 31 Oct 2026
Use it
import pandas as pd

url = "https://mysteriesdept.com/datasets/DAT0DEDXR84XKZJ/openetruscan-etruscan-machine-learning-corpus-v1-1-0-zenodo/v1.0.csv"
tokens = pd.read_csv(url)
tokens.head()
tokens <- read.csv("https://mysteriesdept.com/datasets/DAT0DEDXR84XKZJ/openetruscan-etruscan-machine-learning-corpus-v1-1-0-zenodo/v1.0.csv")
head(tokens)
SELECT * FROM read_csv_auto('https://mysteriesdept.com/datasets/DAT0DEDXR84XKZJ/openetruscan-etruscan-machine-learning-corpus-v1-1-0-zenodo/v1.0.csv') LIMIT 10;curl -H "Authorization: Bearer $MYSTERIES_TOKEN" -O https://mysteriesdept.com/datasets/DAT0DEDXR84XKZJ/openetruscan-etruscan-machine-learning-corpus-v1-1-0-zenodo/v1.0.csv
Used by
0methods
0runs, with their results
1research session, S-001