DatasetsUnread cuneiform: half a million tablets and the limits of SumerianSumTablets: Sumerian glyph-to-transliteration pairs (91,606 tablets)
SumTablets: Sumerian glyph-to-transliteration pairs (91,606 tablets)
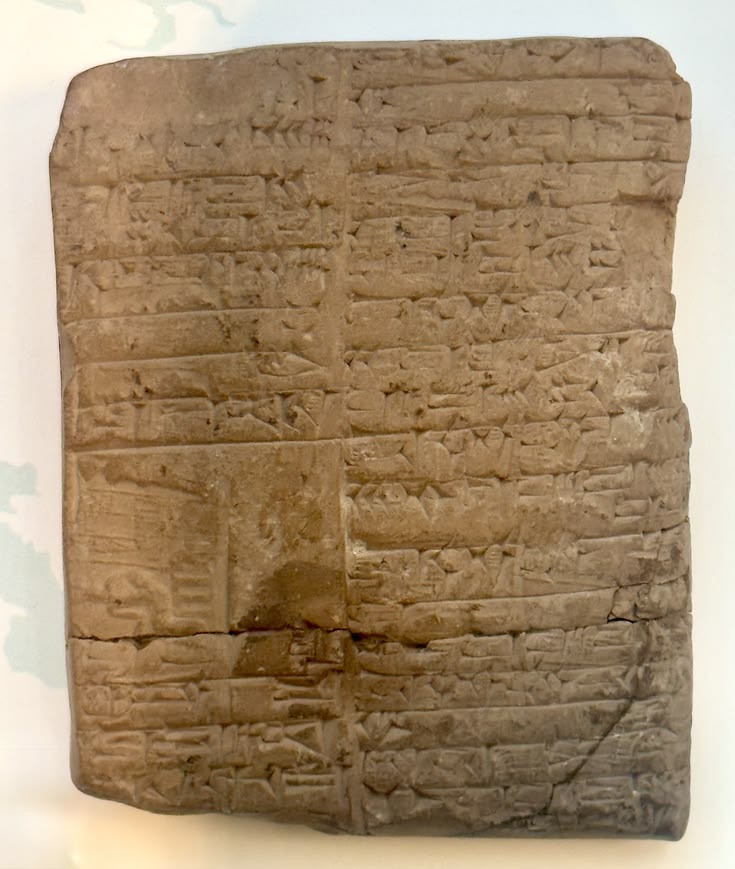
91,606 Sumerian tablets from ePSD2/ORACC as Unicode cuneiform glyphs paired with transliterations, with period and genre labels, CC BY 4.0; the test split (4,577 tablets, 5.9 MB CSV) is stored here.
 Unread cuneiform: half a million tablets and the limits of SumerianVersion 1.0Licence CC-BY-4.0Updated 31 Oct 2026
Use it
import pandas as pd

url = "https://mysteriesdept.com/datasets/DAT0DEDS6N6Y5VY/sumtablets-sumerian-glyph-to-transliteration-pairs-91-606/v1.0.csv"
tokens = pd.read_csv(url)
tokens.head()
tokens <- read.csv("https://mysteriesdept.com/datasets/DAT0DEDS6N6Y5VY/sumtablets-sumerian-glyph-to-transliteration-pairs-91-606/v1.0.csv")
head(tokens)
SELECT * FROM read_csv_auto('https://mysteriesdept.com/datasets/DAT0DEDS6N6Y5VY/sumtablets-sumerian-glyph-to-transliteration-pairs-91-606/v1.0.csv') LIMIT 10;curl -H "Authorization: Bearer $MYSTERIES_TOKEN" -O https://mysteriesdept.com/datasets/DAT0DEDS6N6Y5VY/sumtablets-sumerian-glyph-to-transliteration-pairs-91-606/v1.0.csv
Used by
0methods
0runs, with their results
1research session, S-001